Form denetimi, arama ya da veri temizliği için düzenli ifade yazan geliştiriciler için. Türkçe harflerde doğru deseni ve kilitlenen desenleri anlatıyor.
Bir formda ad soyad alanını denetleyen desen yazdınız. İngilizce isimlerle çalışıyor, ama "Şükrü Öztürk" yazan kullanıcı "geçersiz ad" hatası alıyor. Ya da arama kutusunda "istanbul" yazınca "İSTANBUL" geçen kayıtlar gelmiyor.
İkisinin de sebebi aynı: düzenli ifade (regex) motorlarının varsayılan ayarları Türkçe harfleri tanımaz. Bu yazıda 6 deseni Regex Test Aracı'nda denedik ve Türkçe metin için doğru yazımı gösterdik.
Kısaca
\w ve [a-z] yalnız İngiliz alfabesini tanır
\w "kelime karakteri" diye bilinir, ama JavaScript'te yalnız a-z, A-Z, 0-9 ve alt çizgiyi kapsar. [a-z] aralığı da adından beklenenden dardır: bilgisayar harfleri kod numarasına göre sıralar ve ç, ğ, ı, ö, ş, ü bu numaralarda z'den sonra gelir. Aralığın içine düşmezler.
Girişteki form örneği tam olarak buna takılıyor. Sık görülen ad soyad deseni ^[a-zA-Z ]+$ "John Smith" için doğru, "Şükrü Öztürk" için yanlış sonuç verir. Tarayıcının kendi motoruyla denediğimizde de sonuç böyle çıktı: ilk ad geçti, ikincisi reddedildi. Kullanıcı hatalı bir şey yazmadı; desen onun alfabesini tanımadı.
Bunu bir kütüphane rafı gibi düşünün: raf A'dan Z'ye etiketlenmiş, Türkçe harfler ise binanın başka katında duruyor. Rafı ne kadar dikkatli tararsanız tarayın, o kitapları bulamazsınız.
i ve İ: büyük küçük harf tuzağı
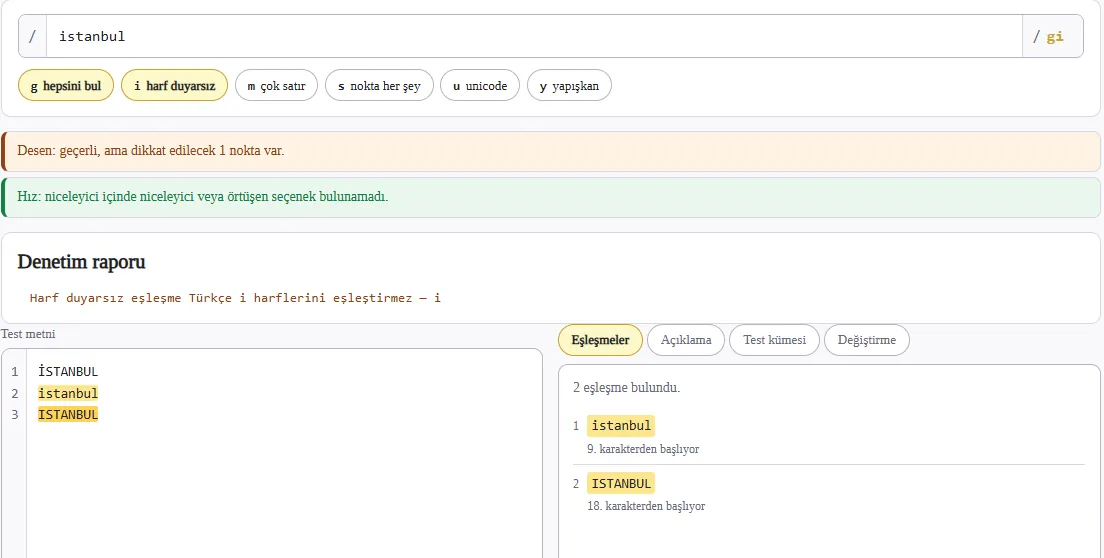
Harf duyarsız eşleşme için kullanılan i bayrağı, büyük küçük harf eşlemesini dilden bağımsız bir tabloya göre yapar. O tabloda i'nin büyüğü I'dır. Türkçede ise iki ayrı harf çifti var: i ile İ, ı ile I. Bu yüzden /istanbul/i deseni "ISTANBUL"u bulur ama "İSTANBUL"u bulmaz.
Tarayıcının kendi fonksiyonunda da aynı fark görülür. "İ".toLowerCase() tek bir i vermez, i ve üstüne bir nokta işaretinden oluşan iki karakterlik bir metin verir. "İ".toLocaleLowerCase("tr") ise doğru sonuç olan i'yi verir.
Denedik: 6 desen, 6 sonuç
Her deseni araca yazıp aynı metinle çalıştırdık. Dil seçimi JavaScript idi. Sonuçları tarayıcının kendi düzenli ifade motoruyla da karşılaştırdık, iki taraf aynı çıktı.
| Desen | Metin | Araçta çıkan sonuç | Aracın uyarısı |
|---|---|---|---|
/\w+/g |
Şanlıurfa | 2 eşleşme: "anl" ve "urfa" | Kelime kaçışı Türkçe harfleri kapsamaz |
/istanbul/i |
İSTANBUL | Eşleşme yok | Harf duyarsız eşleşme Türkçe i harflerini eşleştirmez |
/[a-z]+/g |
çiçek | 2 eşleşme: "i" ve "ek" | Harf aralığı Türkçe harfleri kapsamaz |
/[a-zçğıöşü]+/giu |
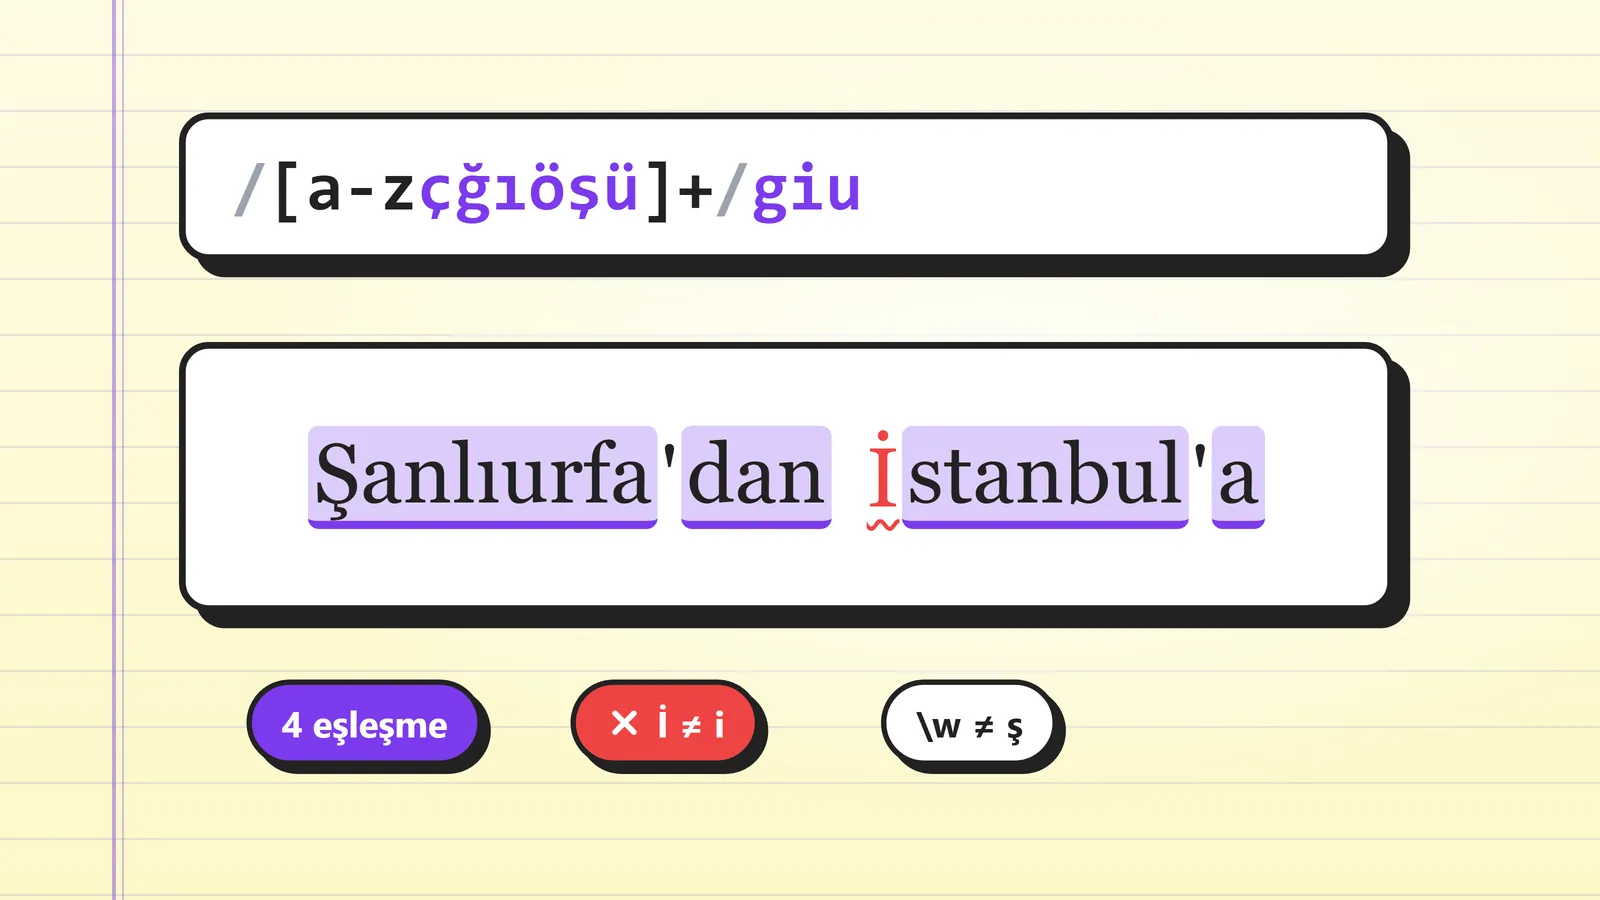
Şanlıurfa'dan İstanbul'a | 4 eşleşme: Şanlıurfa, dan, stanbul, a | İki uyarı: harf aralığı ve i harfleri |
/\p{L}+/gu |
Şanlıurfa'dan İstanbul'a | 4 eşleşme: Şanlıurfa, dan, İstanbul, a | Uyarı yok |
(a+)+$ |
24 a ve bir ünlem | Eşleşme yok | Bu desen kilitleniyor |
Dördüncü satır öğretici. Türkçe küçük harfleri elle eklemek ve i bayrağını açmak Ş'yi yakaladı ama İ'yi yakalamadı; "İstanbul" yerine "stanbul" çıktı. Elle yapılan liste bir harfi hep unutur. Harfleri tek tek saymak yerine "herhangi bir dildeki harf" demek daha sağlam: bu da \p{L}.
Doğru yazım: \p{L} ve u bayrağı
\p{L} bir Unicode özellik kaçışıdır ve "herhangi bir harf" anlamına gelir: Türkçe, Almanca, Yunanca fark etmez. JavaScript'te yalnız u bayrağıyla çalışır. Bayrak olmadan desen hiçbir şey bulmaz; araç da bu durumda "Unicode özellik kaçışı u bayrağı olmadan çalışmaz" uyarısı veriyor.
\p{L}+Ad soyad denetimi için boşluk ve kesme işaretine de izin veren bir örnek:
^[\p{L}' ]+$Dil seçici burada işe yarıyor. Aynı deseni Python seçeneğiyle denediğimizde araç "Bu özellik seçtiğiniz dilde yok" uyarısını verdi: Python'un yerleşik re modülü \p{L} tanımaz. Deseni hangi dilde kullanacaksanız aracı o dile ayarlayın.
Büyük küçük harf için desen yerine metni düzeltin. Karşılaştırmadan önce iki tarafı da Türkçe kurallarıyla küçültürseniz "İSTANBUL" ve "istanbul" aynı metne döner ve i bayrağına gerek kalmaz.
metin.toLocaleLowerCase("tr").includes("istanbul")Kilitlenen desenler: (a+)+ neden tehlikeli?
(a+)+$ ilk bakışta zararsız görünür. Sonunda eşleşmeyen bir karakter olunca motor, a'ları iç ve dış gruba bölmenin her yolunu tek tek dener. Olasılık sayısı her yeni harfle katlanır.
Araç bunu tahmin etmiyor, ölçüyor: kendi saldırı girdisini üretip süreyi milisaniye olarak yazıyor. Bizim denememizde 28 karakterlik girdi 3617 ms sürdü ve araç "girdi uzadıkça süre katlanıyor" dedi. Birkaç karakter daha eklenince aynı desen bir sunucuyu saniyelerce meşgul edebilir.
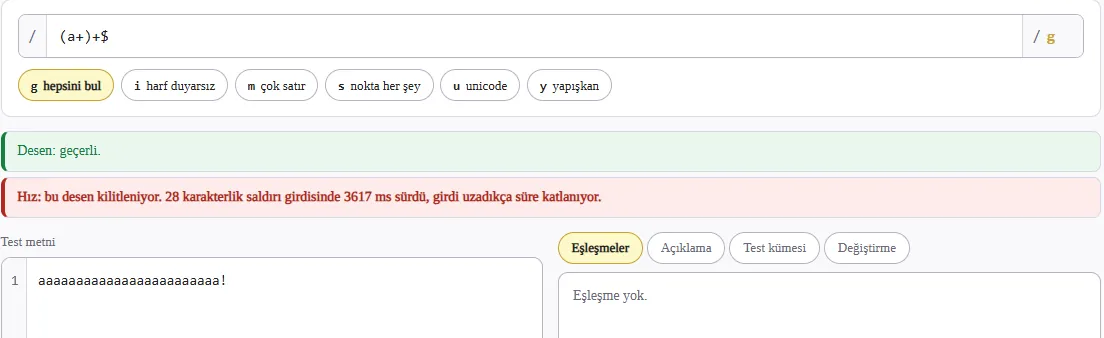
Güvenli desenlerde aynı satır yeşil çıkıyor ve "niceleyici içinde niceleyici veya örtüşen seçenek bulunamadı" yazıyor. Bu satırı her desen değişikliğinden sonra bir kez okumak yeterli.
Çözüm çoğu zaman iç içe niceleyiciyi kaldırmaktır: (a+)+$ yerine a+$ aynı metni bulur ve kilitlenmez.
Test kümesi ve aracın sınırları
Bir desen tek bir örnekte çalışıyor diye her yerde çalışmaz. Aracın Test kümesi sekmesinde eşleşmesi ve eşleşmemesi gereken satırları yazabiliyorsunuz; desen her değiştiğinde hepsi yeniden çalışıyor. Denememizde "Şanlıurfa" ve "İstanbul" eşleşmeli, "Ankara06" eşleşmemeli diye üç satır ekledik. ^[a-zçğıöşü]+$ deseni i ve u bayraklarıyla "2 satır geçti, 1 satır kaldı" sonucunu verdi. Kalan satır İstanbul'du. ^\p{L}+$ deseninde "3 satırın hepsi geçti".
Araç eşleşmeleri tarayıcının düzenli ifade motoruyla buluyor. Seçtiğiniz dilin farklarını uyarı olarak gösteriyor, ama o dilin motorunu çalıştırmıyor. Python için verdiği uyarıya rağmen eşleşmeleri yine listeledi. Sonucu kendi dilinizde, kendi kodunuzla bir kez daha denemeniz gerekir.
Dikkat
Kontrol listesi
- Harf için \w ya da [a-z] yerine \p{L} kullanıldı
- \p{L} içeren desende u bayrağı açık
- Büyük küçük harf farkı için metin toLocaleLowerCase("tr") ile küçültüldü
- Desende iç içe niceleyici yok, hız satırı yeşil
- Test kümesinde İ, ı, ş ve ğ içeren satırlar var
- Desen, kullanılacağı dil seçilerek denendi
Türkçe metinle çalışan her desen er geç İ ya da ş harfine takılır. Deseni canlıya almadan önce birkaç Türkçe örnekle Regex Test Aracı'nda denemek bu hatayı kullanıcıdan önce görmenizi sağlar.
Bu denemeyi 27 Eylül 2026'da Chrome'da yaptık. Örnek metinler kurgusaldır.
Kaynaklar
Bahsedilen
- Belirtilmemiş
Temel Alınan Çalışma
- Belirtilmemiş
